ارزیابی اسکیل؛ چطور بفهمیم یک اسکیل واقعاً کار میکند
اسکیل بدون ارزیابی فقط یک حدس است. روش سادهی نوشتن سناریوی آزمون، مقایسهی با و بدون اسکیل، معیارهای قبولی و تکرار تا وقتی نتیجه ثابت شود.

بیشتر اسکیلها اینطور ساخته میشوند: کسی یک فایل مینویسد، یک بار امتحانش میکند، نتیجه خوب به نظر میرسد و تمام. دو هفته بعد معلوم میشود اسکیل در نیمی از موقعیتها باز نمیشود یا با مدل دیگری نتیجهی بدی میدهد.
ارزیابی (eval) این حدس را به عدد تبدیل میکند. لازم نیست پیچیده باشد؛ چند سناریوی خوب و یک جدول ساده کافی است.
سناریوی آزمون چیست؟
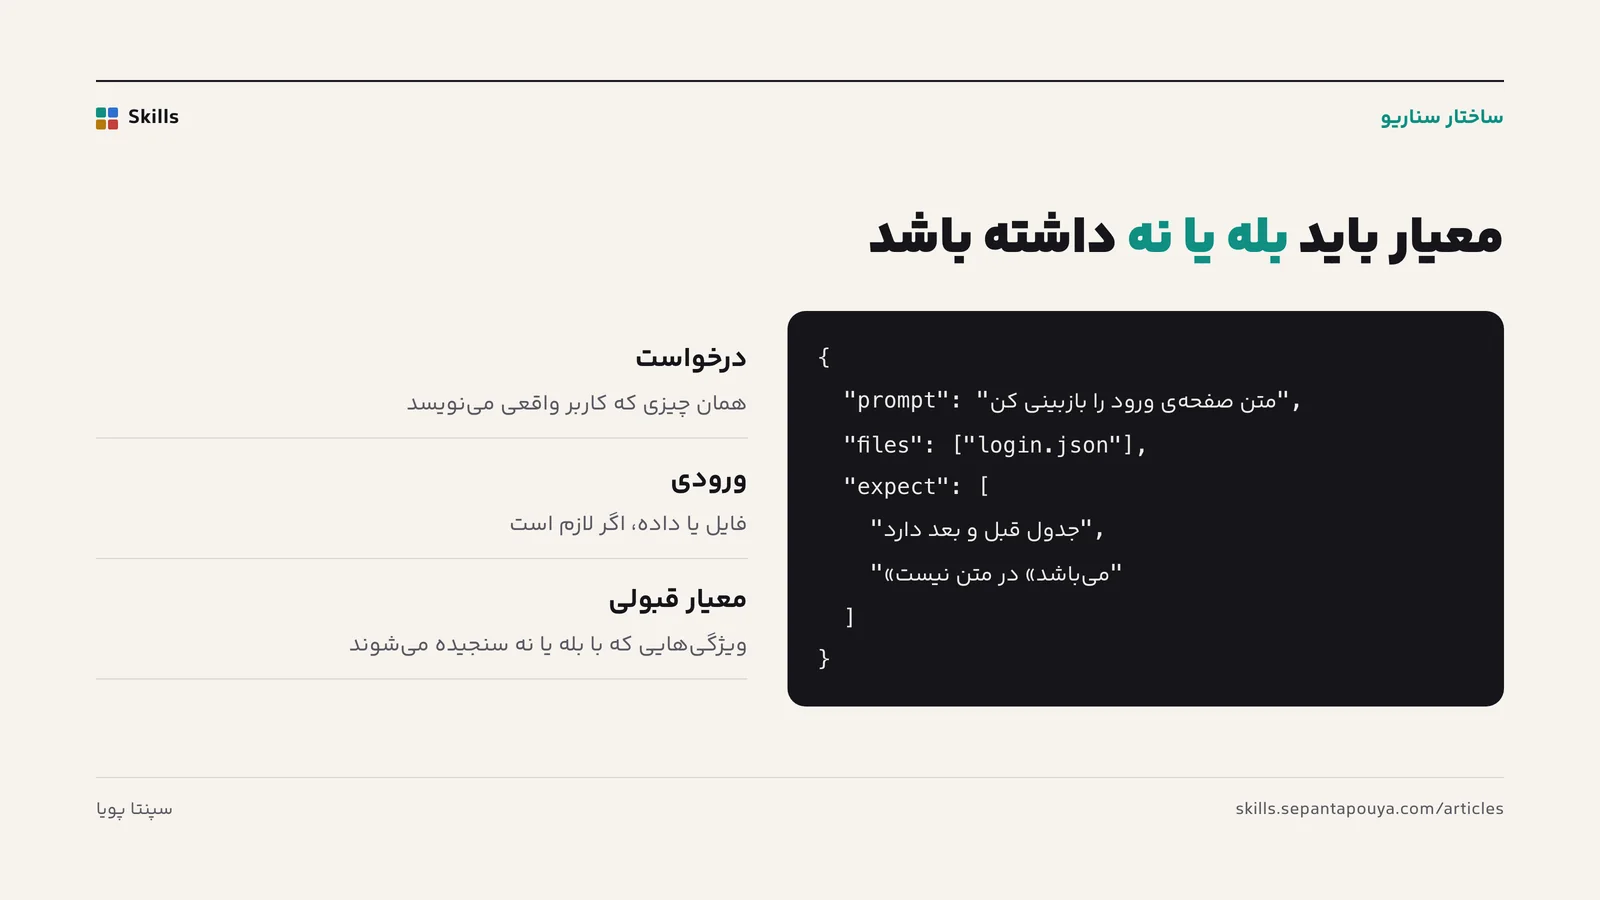
هر سناریو سه بخش دارد:
- درخواست: دقیقاً همان چیزی که کاربر واقعی مینویسد.
- ورودی: فایلها یا دادهای که کار روی آن انجام میشود، اگر لازم است.
- معیار قبولی: ویژگیهایی که خروجی درست حتماً دارد، طوری نوشته شده که بشود با بله یا نه جواب داد.
{
"prompt": "متن صفحهی ورود اپ ما را بازبینی کن",
"files": ["login.json"],
"expect": [
"جدول قبل و بعد با دلیل هر تغییر دارد",
"هیچ «میباشد» یا «با موفقیت» در متن پیشنهادی نیست",
"پیام خطای رمز اشتباه، کاربر را مقصر نمیداند"
]
}معیار «خروجی خوب باشد» قابلسنجش نیست؛ «جدول قبل و بعد دارد» هست.
اول بدون اسکیل اجرا کنید
مهمترین قدم، و قدمی که بیشتر از همه جا میافتد: هر سناریو را یک بار بدون اسکیل اجرا کنید. این دو چیز را نشان میدهد:
- مدل کجا از قبل خوب است. برای این بخشها لازم نیست چیزی بنویسید.
- شکافهای واقعی کجاست. اسکیل را فقط برای همینها بنویسید.
این روش جلوی اسکیلهای طولانی پر از توضیح بدیهی را میگیرد؛ همان چیزی که راهنمای رسمی Anthropic با عنوان «اول ارزیابی، بعد مستندات» توصیه میکند.
چند سناریو کافی است؟
دستکم سه، و معمولاً پنج تا ده برای یک اسکیل جدی. ترکیب خوب:
- سناریوهای اصلی: کاری که اسکیل برایش ساخته شده.
- سناریوهای مرزی: درخواست مبهم، ورودی ناقص، فایل خیلی بزرگ.
- سناریوهای «نباید»: درخواستهایی که اسکیل نباید به آنها دست بزند.
جدول نتیجه
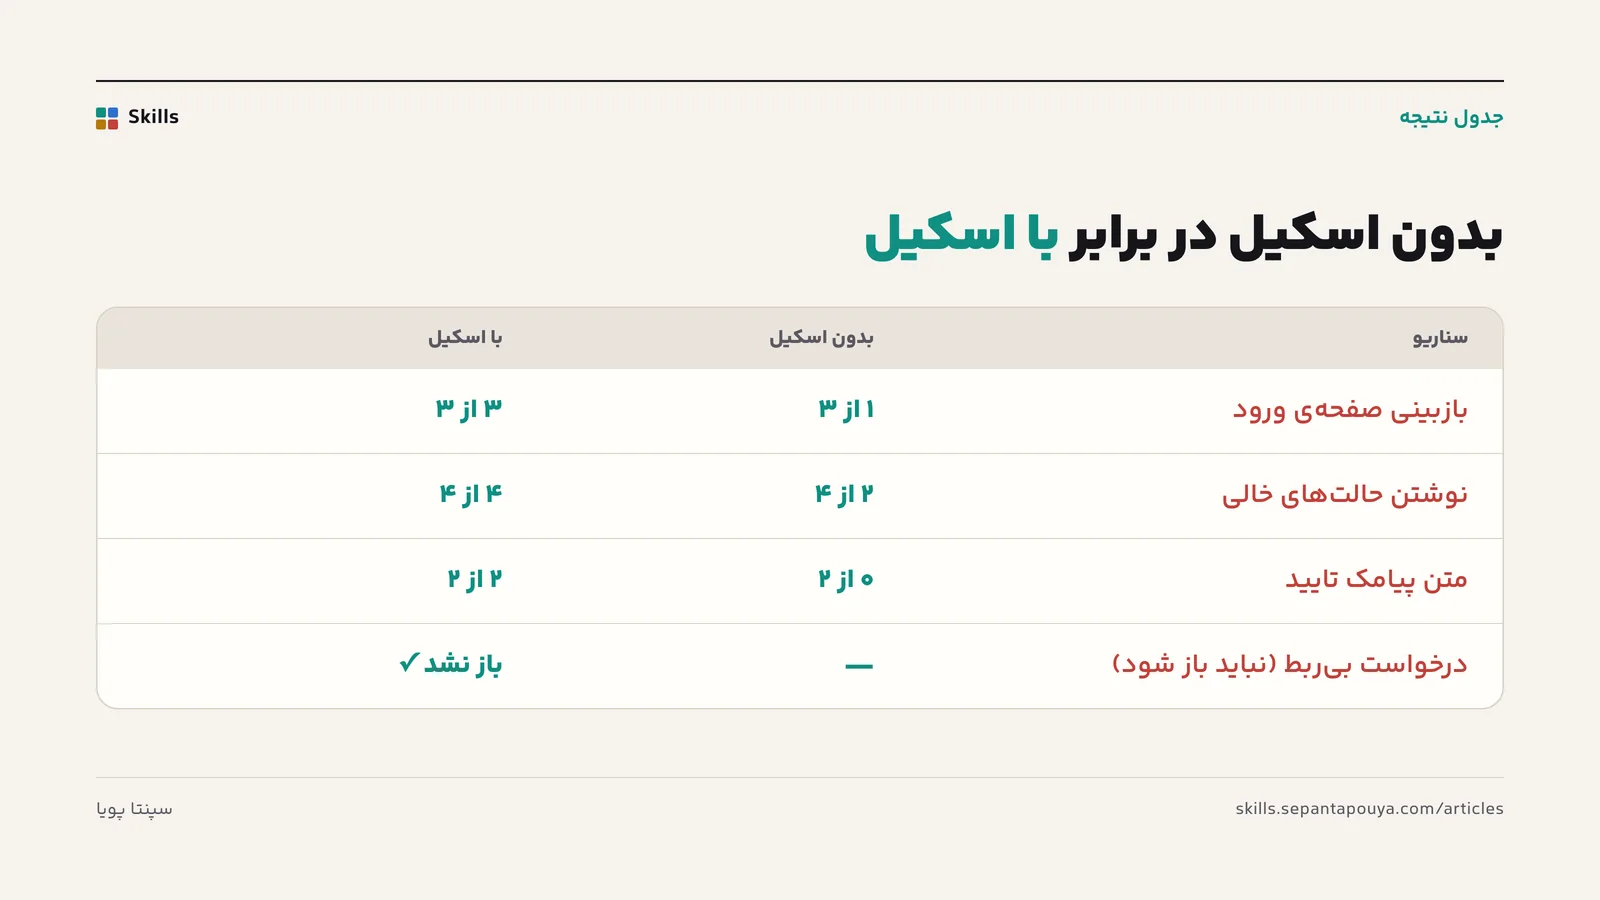
نتیجه را در یک جدول ساده نگه دارید: هر سطر یک سناریو، هر ستون یک معیار، و در خانهها بله یا نه. یک ستون «بدون اسکیل» و یک ستون «با اسکیل» کنار هم، فوراً نشان میدهد اسکیل چقدر فرق ایجاد کرده.
با چند مدل تست کنید
اسکیلی که با قویترین مدل عالی است، ممکن است با مدل سبکتر راهنمایی کم داشته باشد. سناریوها را با همهی مدلها و ابزارهایی که کاربرانتان استفاده میکنند اجرا کنید. اسکیلهای این سایت روی Claude Code، Codex و Cursor تست شدهاند، چون رفتار هر ابزار در اجرای اسکریپت کمی فرق دارد.
وقتی ارزیابی شکست خورد
هر سناریوی ناموفق یک سؤال دارد: مشکل از کجاست؟
- اسکیل باز نشد → description را اصلاح کنید (راهنمای description).
- باز شد ولی دستورالعمل را دنبال نکرد → دستورالعمل مبهم است یا خیلی طولانی.
- دنبال کرد ولی نتیجه غلط بود → این بخش احتمالاً اسکریپت میخواهد، نه توضیح بیشتر.
خلاصه
سناریوی واقعی، معیار بله یا نه، اجرای بدون اسکیل پیش از نوشتن، جدول نتیجه و تست با چند مدل. با همین پنج قدم، اسکیل از حدس به ابزاری تبدیل میشود که میدانید کار میکند.
طراح محصول و سازندهی دیزاینسیستم کاشی. سایتهای زیادی را با هوش مصنوعی ساختهام و چند سال اخیر روی ایجنتیک کردن فرایندهای هوش مصنوعی کار کردهام. اسکیلهای این سایت همانهاییاند که خودم هر روز با آنها کار میکنم.
بیشتر دربارهی منچیزی که خواندید را همین امروز به دستیارتان بدهید
همهی این اسکیلها با لایسنس دائمی، بهروزرسانی رایگان برای همیشه و راهنمای نصب برای همهی ابزارها.
اسکیلساز حرفهای
اسکیلی برای ساختن اسکیل؛ از مصاحبه و eval تا نوشتن، اعتبارسنجی و بستهبندی، برای Claude، Codex، Cursor و Gemini.