چرا هوش مصنوعی رابط و متن فارسی را خراب میکند و چطور درستش کنیم
نیمفاصلهی گمشده، «ي» عربی، علامتهایی که جابهجا میشوند و چیدمانی که برعکس نشده. شش خطای رایج هوش مصنوعی در محصول فارسی و روشی که جلوی همهشان را میگیرد.

از Claude یا Codex بخواهید یک فرم ثبتنام فارسی بسازد. کد تمیز است، رنگها خوباند و در نگاه اول همهچیز درست به نظر میرسد. بعد دقیقتر نگاه میکنید: «میخواهید» بدون نیمفاصله، علامت سؤال انگلیسی، شمارهی تلفن با ارقام لاتین، آیکون فلش که به سمت اشتباه اشاره میکند و دکمهای که فقط نوشته «تایید».
هیچکدام از اینها بهتنهایی فاجعه نیست، ولی جمعشان محصول را ترجمهشده نشان میدهد، نه ساختهشده برای فارسیزبانها. در این مقاله شش خطای پرتکرار را میبینید، دلیلشان را، و روشی که در پروژههایم برای جلوگیری از همهشان استفاده میکنم.
چرا این اتفاق میافتد؟
مدلهای زبانی از متنهای اینترنت یاد گرفتهاند، و بخش بزرگی از متن فارسی اینترنت خودش این خطاها را دارد: کیبوردهایی که «ي» عربی تایپ میکنند، سایتهایی که نیمفاصله را با فاصلهی کامل یا چسباندن جایگزین کردهاند و رابطهایی که از انگلیسی ترجمهی کلمهبهکلمه شدهاند. مدل چیزی را تکرار میکند که بیشتر دیده، نه چیزی که درست است.
مشکل دوم این است که بیشتر کدهای رابطی که مدل دیده چپبهراست طراحی شدهاند. پس وقتی رابط فارسی میسازد، معمولاً متن را راستچین میکند ولی منطق چیدمان، جهت آیکونها و فاصلهها را همانطور چپبهراست نگه میدارد.
۱. نیمفاصلهای که فاصله یا چسبیده شده
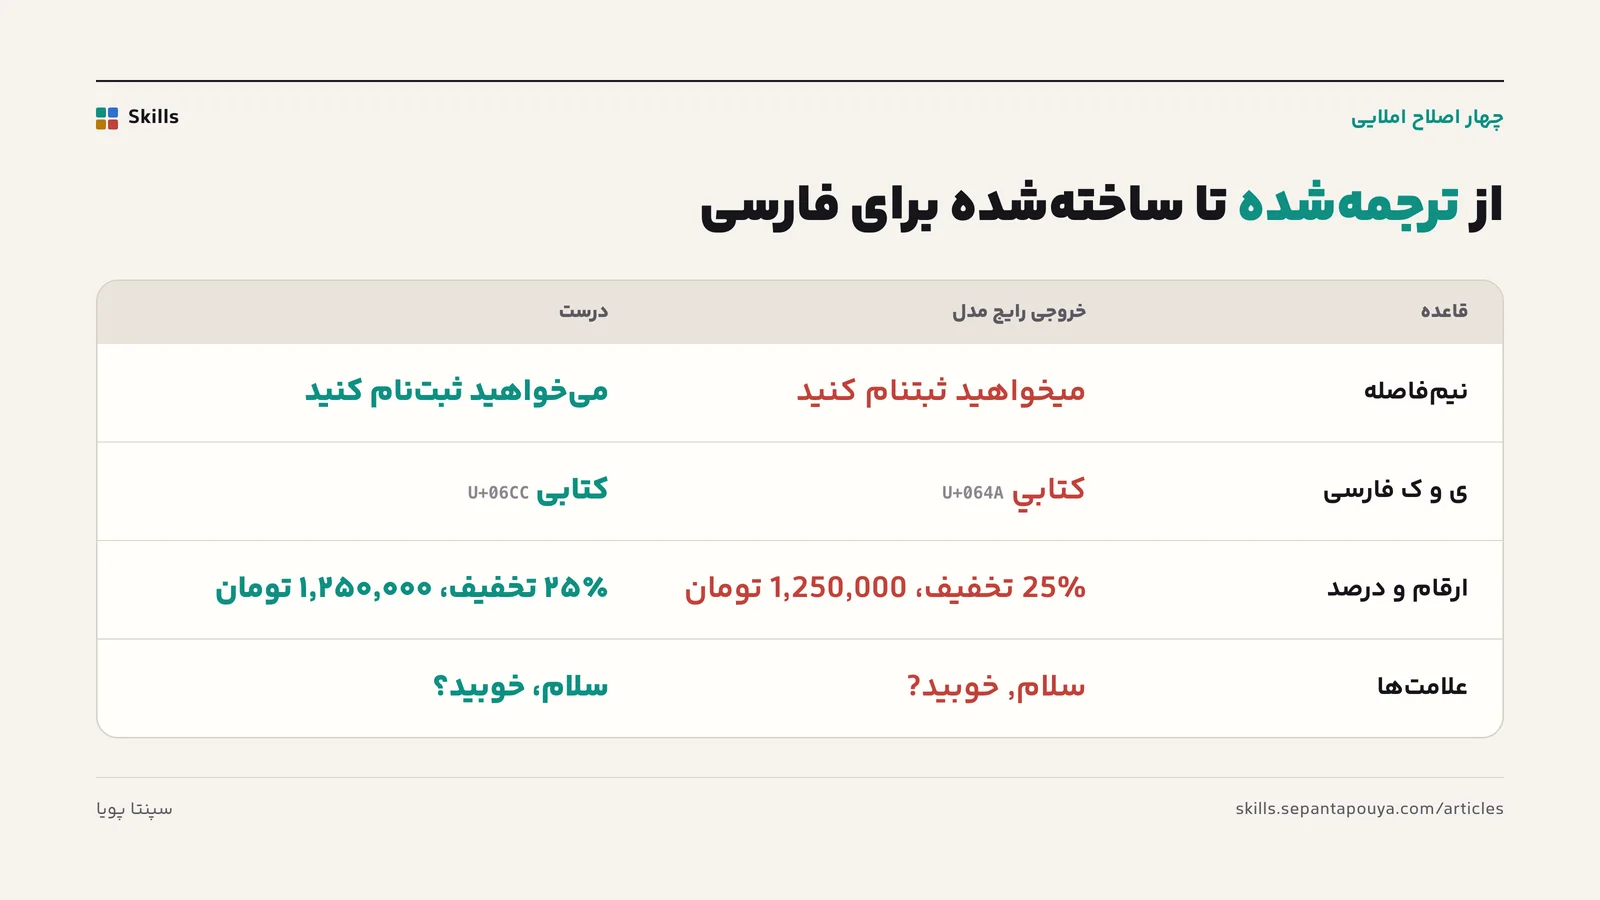
نیمفاصله (ZWNJ) در فارسی اختیاری نیست؛ بخشی از املای درست است. «میخواهم»، «کتابها»، «سریعتر» و «کسبوکار» بدون آن یا غلط خوانده میشوند یا ظاهر شلخته دارند. مدلها معمولاً یکی از دو اشتباه را میکنند: یا کامل میچسبانند («میخواهم») یا فاصلهی کامل میگذارند («می خواهم»)، که در انتهای خط ممکن است «می» را تنها در یک خط و «خواهم» را در خط بعد بیندازد.
۲. «ي» و «ك» عربی
این خطا با چشم تقریباً دیده نمیشود، ولی جستوجو را خراب میکند. اگر نام محصولی در دیتابیس با «ي» عربی ذخیره شده باشد، کاربری که با کیبورد فارسی «ی» تایپ میکند، آن را پیدا نمیکند. همیشه «ی» (U+06CC) و «ک» (U+06A9) فارسی؛ و در ورودیهای جستوجو، هر دو شکل را به شکل فارسی تبدیل کنید.
۳. ارقام و علامتهای لاتین وسط متن فارسی
«۲۵٪ تخفیف» درست است و «25% تخفیف» نه. همینطور «سلام، خوبید؟» با ویرگول و علامت سؤال فارسی. جداکنندهی هزارگان هم «٬» است: «۱٬۲۵۰٬۰۰۰ تومان». ارقام لاتین فقط کنار کلمههای لاتین و در کد جا دارند.
یک نکتهی ظریف: شمارهی کارت، تلفن و شبا از چپ به راست نوشته میشوند، ولی در رابط فارسی ارقامشان همچنان فارسی است.
۴. علامتهایی که با متن انگلیسی جابهجا میشوند
جملهای مثل «فایل SKILL.md را باز کنید.» را در نظر بگیرید. اگر بخش انگلیسی جدا نشود، الگوریتم دوجهتهی مرورگر ممکن است نقطه یا پرانتز را به جای اشتباهی ببرد و جمله بههم بریزد. مدلها تقریباً هیچوقت این را پیشبینی نمیکنند.
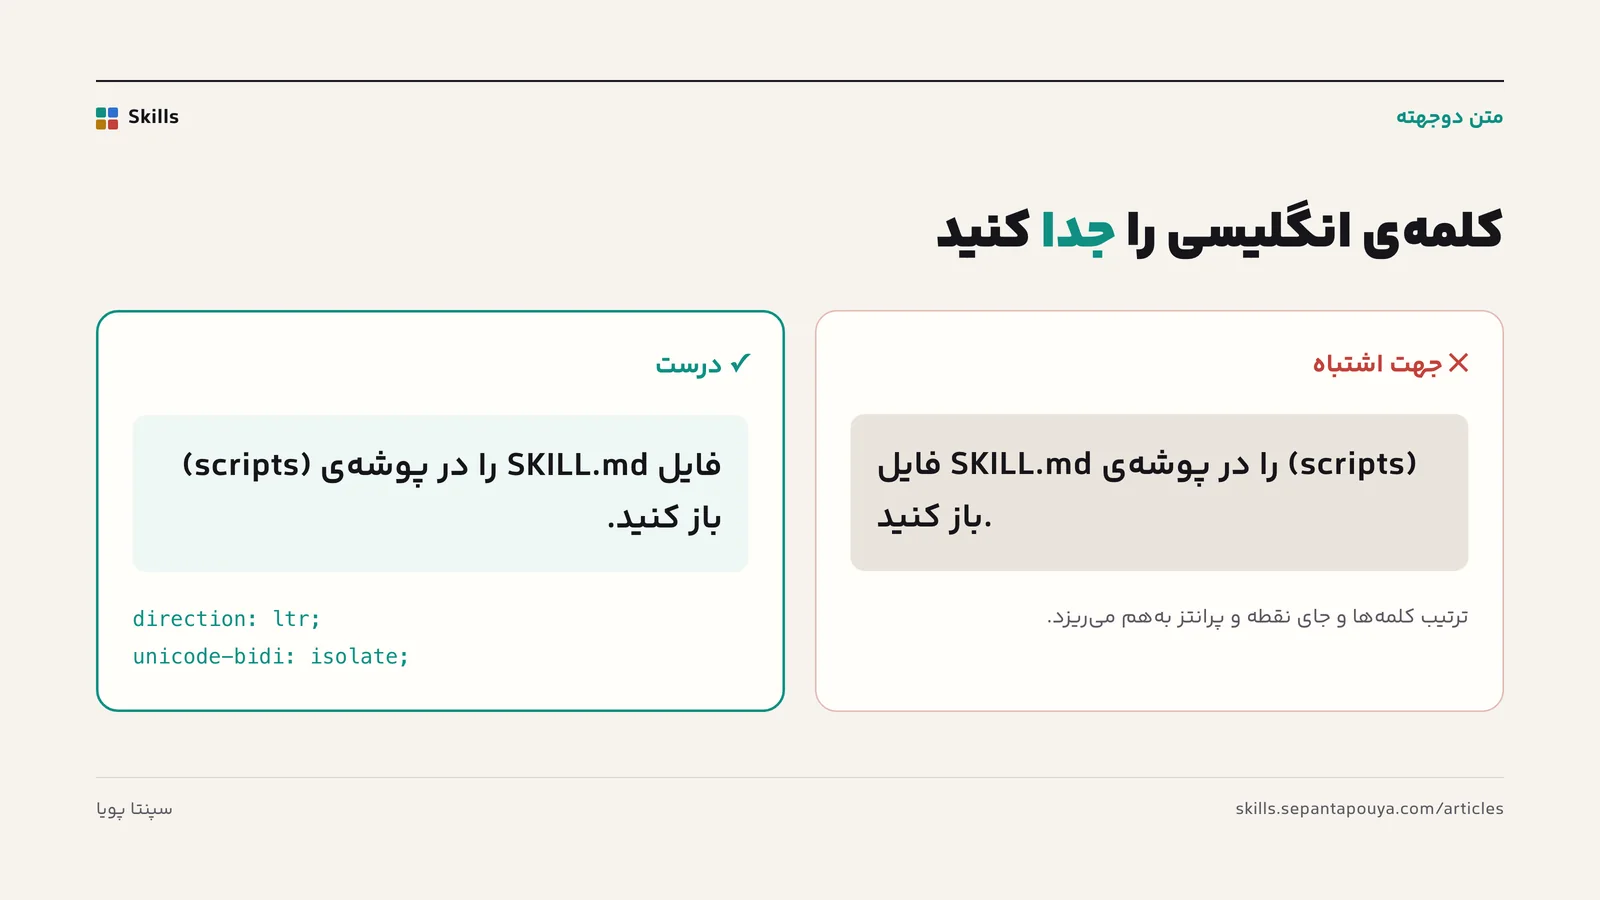
راهحل در CSS ساده است: هر تکهی انگلیسی، کد، نام فایل یا میانبر کیبورد را در یک عنصر با direction: ltr و unicode-bidi: isolate بگذارید. در HTML هم عنصر همین کار را میکند.
۵. چیدمانی که فقط راستچین شده، نه برعکس
رابط راستبهچپ فقط text-align: right نیست. ترتیب ستونها، جهت فلش «بعدی» و «قبلی»، محل آیکون در دکمه، جهت نوار پیشرفت و حتی سمت باز شدن منوها باید برعکس شوند. اشتباه رایج مدلها استفاده از margin-left و padding-right است که در RTL برعکس کار میکنند.
راه درست استفاده از ویژگیهای منطقی CSS است: margin-inline-start بهجای margin-left و inset-inline-end بهجای right. اینطوری یک کد در هر دو جهت درست کار میکند. آیکونهایی که جهت دارند (فلش، «بازگشت»، «ارسال») باید در RTL قرینه شوند؛ آیکونهایی که جهت ندارند (جستوجو، تنظیمات) نه.
۶. متن رابطی که ترجمه شده، نه نوشته شده
«عملیات با موفقیت انجام گردید»، «لطفاً مجدداً تلاش نمایید» و دکمهای که فقط نوشته «تایید». اینها ترجمهی مستقیم الگوهای انگلیسی یا تقلید از نامههای اداریاند. متن رابط خوب به یک سؤال کاربر جواب میدهد: این چیست، چه کنم، چه شد، حالا چه؟
| ترجمهشده | نوشتهشده برای کاربر |
|---|---|
| عملیات با موفقیت انجام گردید | سفارش ثبت شد |
| خطایی رخ داده است | ایمیل یا رمز عبور درست نیست. |
| تایید | پرداخت ۲۵۰٬۰۰۰ تومان |
| لطفاً مجدداً تلاش نمایید | اتصال قطع شد. دوباره امتحان کنید. |
دکمهها فعلیاند که میگویند چه اتفاقی میافتد. خطاها میگویند چه شد و حالا چه کنیم، بدون مقصر دانستن کاربر و بدون علامت تعجب.
راهحل: قاعده، ابزار، بازبینی
گفتن «فارسی را درست بنویس» به مدل کافی نیست؛ مدل نمیداند «درست» دقیقاً یعنی چه. چیزی که در پروژههایم جواب داده، ترکیب سه لایه است:
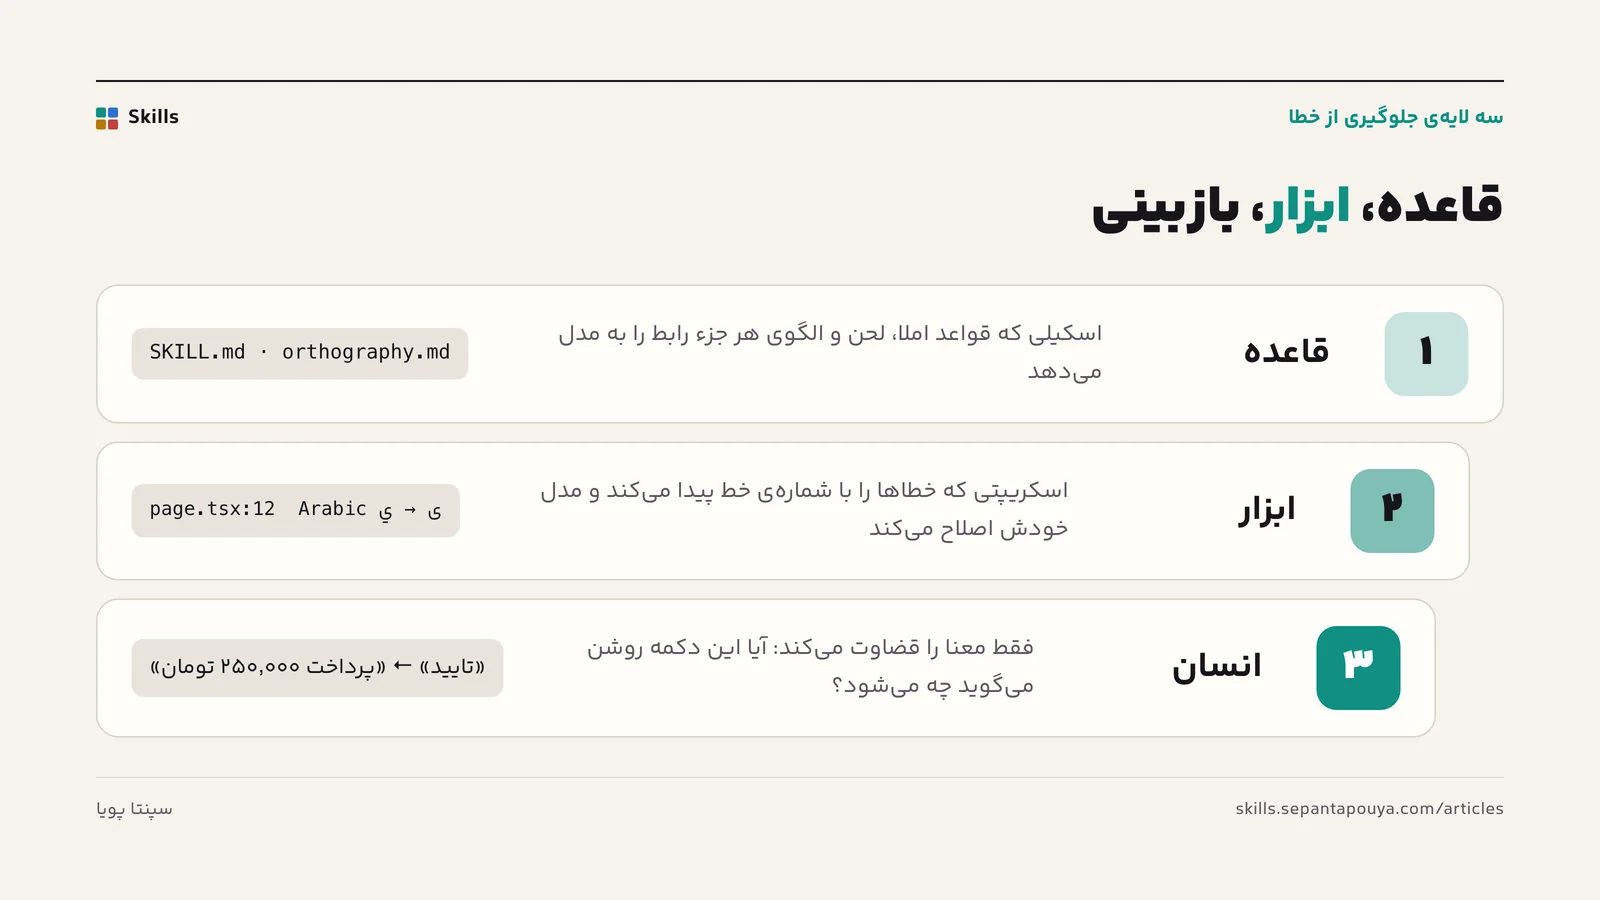
- قاعده در قالب اسکیل: قواعد املا (بر پایهی دستور خط فرهنگستان)، لحن و الگوی هر جزء رابط در یک اسکیل نوشته میشود تا مدل هر بار که متن فارسی مینویسد، همان قواعد را بخواند.
- بررسی خودکار: یک اسکریپت کوچک کل پروژه را میگردد و «ي» عربی، نیمفاصلهی گمشده، ارقام لاتین، علامتهای انگلیسی و عبارتهای اداری مثل «میباشد» را با شمارهی خط گزارش میکند. مدل خودش خروجی را اجرا و اصلاح میکند.
- بازبینی انسانی برای معنا: ابزار نمیتواند بگوید «تایید» برای این دکمه مبهم است. این بخش کار شماست، ولی حالا وقتتان صرف معنا میشود، نه شمردن نیمفاصلهها.
برای بخش چیدمان هم همین منطق برقرار است: یک دیزاینسیستم فارسی که از اول با ویژگیهای منطقی CSS، فونت فارسی، تقویم شمسی و قواعد قرینهسازی ساخته شده، جلوی بیشتر خطاها را قبل از اینکه مدل حتی کد بنویسد میگیرد.
جمعبندی
هوش مصنوعی فارسی را بد نمینویسد چون نمیتواند؛ بد مینویسد چون اغلب نمونههایی که دیده بد بودهاند و کسی دقیق به او نگفته درست یعنی چه. وقتی قواعد را در یک اسکیل بنویسید و با یک ابزار بررسی کنید، همان مدل متنی مینویسد که انگار یک نویسندهی فارسیزبان دقیق نوشته.
اسکیل نویسندهی رابط فارسی همین سه لایه را آماده دارد: قواعد املا و لحن، الگوی همهی اجزای رابط و اسکریپت بررسی خودکار. برای ساختن خود رابط هم اسکیل ساخت دیزاینسیستم فارسی را ساختهام.
طراح محصول و سازندهی دیزاینسیستم کاشی. سایتهای زیادی را با هوش مصنوعی ساختهام و چند سال اخیر روی ایجنتیک کردن فرایندهای هوش مصنوعی کار کردهام. اسکیلهای این سایت همانهاییاند که خودم هر روز با آنها کار میکنم.
بیشتر دربارهی منچیزی که خواندید را همین امروز به دستیارتان بدهید
همهی این اسکیلها با لایسنس دائمی، بهروزرسانی رایگان برای همیشه و راهنمای نصب برای همهی ابزارها.
یوایکس رایتر فارسی
متن رابط سایت و اپ شما را بازنویسی میکند یا از صفر مینویسد: دکمه، خطا، حالت خالی، اعلان، لحن برند و درستنویسی.
ساخت و توسعهی دیزاینسیستم فارسی
تجربهی ۲۱۵ کامیت ساخت کاشی در یک اسکیل: از توکن و RTL تا دادههای ایرانی، دسترسپذیری، تست تصویری و انتشار نسخه.